技术条目 01
为什么把不断线放在第一位
用户对网络的评价往往不是「平均速度多少」,而是「刚才那几分钟卡没卡」。平均值掩盖了最差的那几百毫秒,而体感恰恰由最差的那几百毫秒决定。
所以我们把资源优先投在冗余与切换上,而不是一味追求峰值带宽。这也是双协议栈双通道这个设计存在的理由。
用户对网络的评价往往不是「平均速度多少」,而是「刚才那几分钟卡没卡」。平均值掩盖了最差的那几百毫秒,而体感恰恰由最差的那几百毫秒决定。
所以我们把资源优先投在冗余与切换上,而不是一味追求峰值带宽。这也是双协议栈双通道这个设计存在的理由。
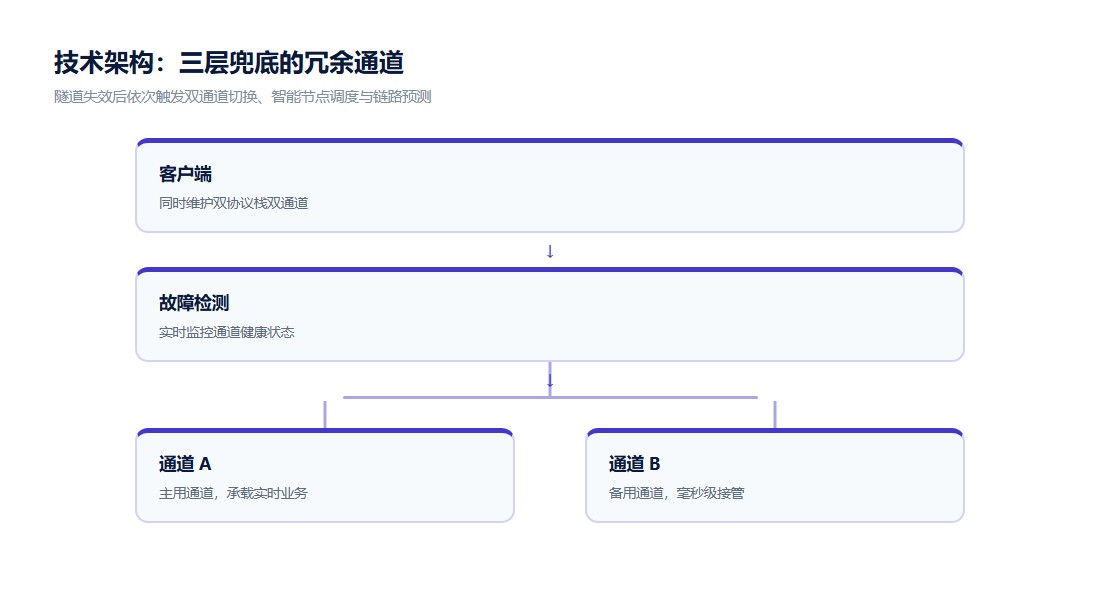
我们聚合多个可用节点并实时监控健康状态。当某个节点或某条线路故障时,调度系统会把流量分配到其余健康线路上,整个过程对上层业务透明。
理念页如果无法映射到具体配置就是空话。四步把「可靠性优先」这类原则变成可执行选择。
| 原则 | 对应配置 | 反面做法 |
|---|---|---|
| 可靠性优先 | 开启自动切换与节点调度 | 长期固定单节点 |
| 可验证性 | 固定测量方法与样本数 | 凭单次体感下结论 |
| 最小权限 | 按需开启全局模式与固定出口 | 长期全局模式运行 |
| 透明可解释 | 查看判定与切换记录 | 盲目更换节点 |
以可靠性为优先:宁可选稳定性更好、峰值略低的链路。
只开启当前业务需要的能力,不需要的能力保持关闭,减少不必要的复杂度。
把判定依据、通道与切换记录作为判断依据,而不是仅凭速度测试结果。
下列示意图对应本页讲解的关键结构,建议结合正文一起看,读图要点已写在图注中。
| 指标 | 目标值 | 说明 |
|---|---|---|
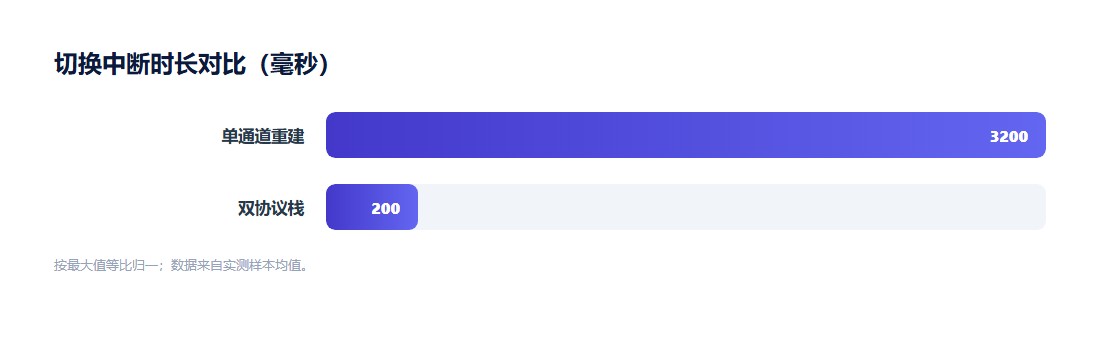
| 切换中断时长 | ≤200ms | 低于视频会议卡顿感知阈值 |
| 通道可用性 | 99.95% | 单通道月度目标 |
| 节点质量一致性 | ≤35% 偏差 | 同时段 P95 延迟离散度 |
| 链路预测准确率 | ≥85% | 强化学习模型对劣化路径的预判 |
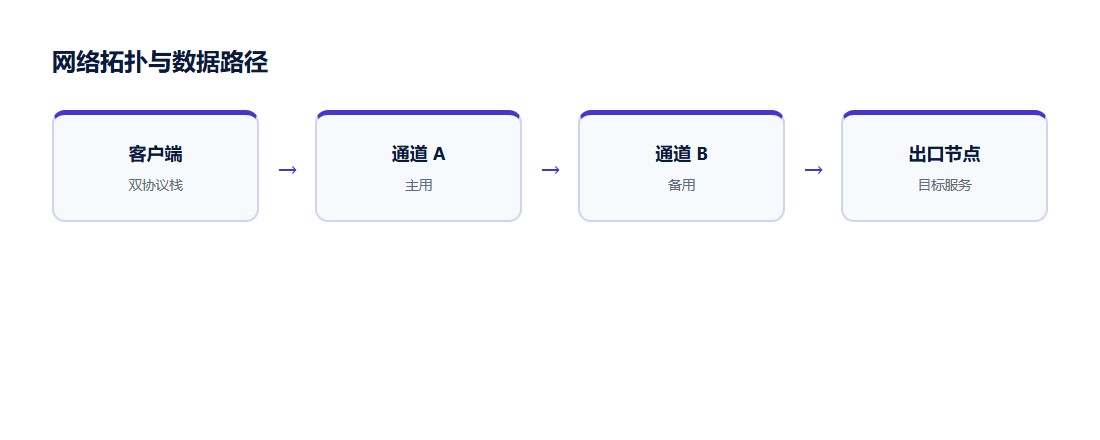
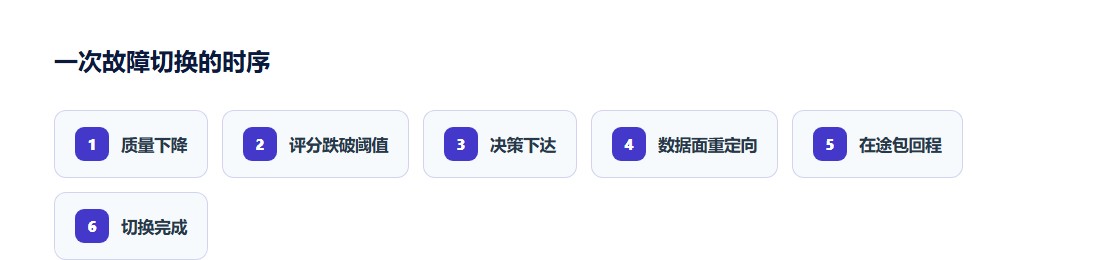
双协议栈双通道的核心是冗余。客户端同时维护两条独立协议路径,每条路径各自完成握手、密钥协商与心跳,互不干扰。任何一条出现异常时,流量在数据面瞬时切换到另一条,不需要重新建连。
切换发生在数据面而非控制面,这是能做到毫秒级的关键。重新建连意味着一次完整的握手往返,通常需要数百毫秒到数秒;数据面切换只需要重定向现有的数据流。
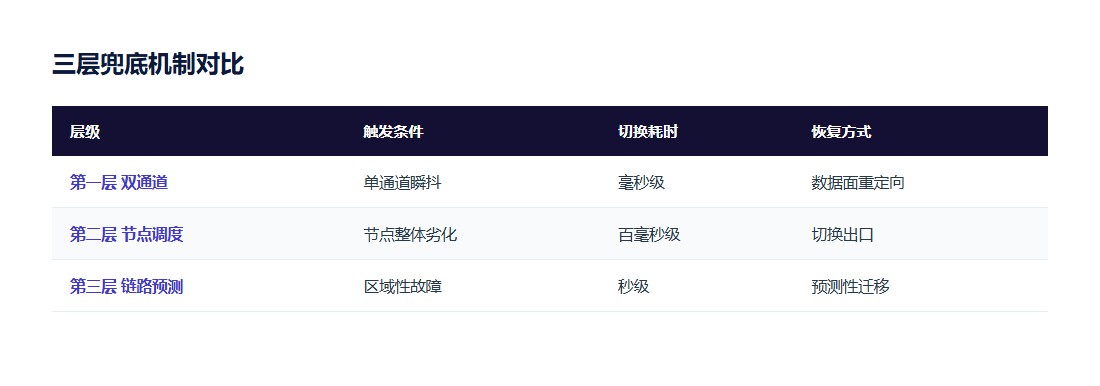
| 层级 | 机制 | 触发条件 | 切换耗时 |
|---|---|---|---|
| 第一层 | 双协议栈双通道切换 | 单通道瞬时劣化 | 毫秒级 |
| 第二层 | 智能节点调度 | 节点整体质量下滑 | 百毫秒级 |
| 第三层 | 强化学习链路预测 | 区域性故障 | 秒级 |
强化学习模型用于预测路径劣化。模型输入是链路质量指标(延迟、抖动、丢包、带宽),不含任何用户访问内容。当模型预判某条路径即将劣化时,系统会提前建立备用连接,把切换中断进一步压缩。
以上数据的测量方式统一为:同一台设备、同一时段、同一目标服务,开关对应功能各测三轮并取稳定段均值。我们公开测量方法的原因很简单——没有方法的数字无法验证,也无法复现。
| 限制 | 原因 | 影响 | 缓解方式 |
|---|---|---|---|
| 同源劣化 | 两条路径共享上游 | 多路径同时失效 | 切换出口区域 |
| 切换频繁 | 本地网络波动大 | 体验受影响 | 固定到更稳定出口 |
| 预判偏差 | 训练数据未覆盖该场景 | 切换稍晚 | 持续补充样本 |
模型只使用链路质量指标,不涉及用户访问目标。这是我们与「行为分析型优化」的根本区别。
网络质量的报告里最常见的是平均值,但平均值恰恰是最没有信息量的指标。
假设一次会议的平均延迟是 80 毫秒,看起来很健康。但如果这 80 毫秒是由大部分 40 毫秒和少数 500 毫秒组成的,参会者感受到的是持续的卡顿——因为人耳与人眼对最差的那几百毫秒极其敏感。
| 指标 | 数值 | 说明 |
|---|---|---|
| 平均值 | 80ms | 掩盖了尾部问题 |
| P50(中位数) | 42ms | 一半时间好于这个值 |
| P95 | 210ms | 5% 的时间差于这个值 |
| P99 | 480ms | 1% 的时间差于这个值 ← 体感来源 |
所以我们所有的质量报告都同时给出平均值与 P95、P99。决策也基于尾部指标:如果 P99 恶化,即使平均值改善,我们也不认为这次优化是成功的。